AI‑coustics – KI-gesteuerte Rausch- & Resonanzunterdrückung für klare Sprache
Übersicht
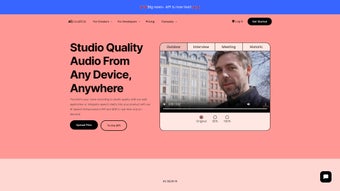
AI‑coustics ist eine fortschrittliche KI-Audioverbesserungslösung, die gewöhnliche Sprachaufnahmen in professionelle, kristallklare Sprache mit Rundfunkqualität verwandelt. Im Gegensatz zu traditionellen Rauschunterdrückungs-Plugins, die lediglich Hintergrundgeräusche filtern, nutzt AI‑coustics eine generative Sprach-KI-Engine, die auf Millionen von Stunden mehrsprachiger Sprache trainiert wurde, um fehlende Frequenzanteile intelligent wiederherzustellen, Raumresonanzen zu unterdrücken und die Frequenzantwort kostengünstiger Mikrofone und Kopfhörer zu korrigieren. Die Software ist speziell für Kreative, Remote-Arbeitnehmer, Lehrkräfte und Entwickler konzipiert, die Studioqualität ohne teure Hardware erreichen möchten.
Ihre Architektur kombiniert einen lokalen Inferenz-Engine für Offline-Verarbeitung mit einer sicheren Cloud-API für hochdurchsatzstarke Aufgaben, sodass Benutzer vollständig offline arbeiten oder die Leistungsfähigkeit serverseitiger GPUs nutzen können. Der integrierte Playground-Demo ermöglicht es jedem, eine kurze Audiodatei hochzuladen und sofort die Transformation zu hören, bevor eine Download-Entscheidung getroffen wird. Dank der plattformübergreifenden SDKs für Windows, macOS, Linux, Web, Android und iOS passt sich AI‑coustics nahtlos in Desktop-Editier-Workflows, Live-Streaming-Pipelines, mobile Apps und Cloud-basierte Transkriptionsdienste ein.
Ob Sie eine Podcast-Folge polieren, die Verständlichkeit eines Zoom-Anrufs verbessern oder Sprachverbesserung in einen benutzerdefinierten KI-Assistenten integrieren – AI‑coustics bietet ein sicheres, skalierbares und einfach zu bedienendes Toolkit, das die Maßstäbe für Sprachklarheit neu setzt.
Wesentliche Funktionen, die AI‑coustics unterscheiden
- Generative Sprach-KI-Engine: Deep-Learning-Modelle analysieren das Audiosignal, prognostizieren fehlende Hochfrequenzanteile und rekonstruieren die Sprache mit natürlichem Klang.
- Unterdrückung von Raumresonanzen: Fortgeschrittene akustische Analyse erkennt stehende Wellenmuster und Nachhall und wendet adaptive Filter an, um diese zu neutralisieren, ohne die Stimme zu beeinträchtigen.
- Kompensation von Kopfhörern & Mikrofonen: Automatisches EQ-Profil stellt die ausgewogene Frequenzantwort für günstige USB-Kopfhörer, Laptop-Mikrofone und eingebaute Handy-Mikrofone wieder her.
- Reparatur digitaler Artefakte: Das System repariert Clipping, Quantisierungsrauschen und Kompressionsartefakte und liefert ein sauberes Signal, das so klingt, als wäre es in einem professionellen Studio aufgenommen worden.
- Frequenzwiederherstellung: Fehlende Hochfrequenzenergie wird regeneriert, was Helligkeit und Verständlichkeit hinzufügt – Merkmale, die typische Rauschunterdrückung oft entfernt.
- Plattformübergreifendes SDK & API: Die HD‑SPEECH-API und SDK unterstützen Windows, macOS, Linux, Web (WebAssembly), Android und iOS und ermöglichen sowohl Cloud-basierte als auch geräteinterne Verarbeitung.
- Echtzeit-Modus mit geringer Latenz: Optimierte Pipelines halten die End-to-End-Latenz unter 120 ms auf moderner Hardware – ideal für Live-Streaming, Gaming-Chat und Videokonferenzen.
- Sichere Cloud-Option: Ende-zu-Ende-TLS 1.3-Verschlüsselung, isolierte Verarbeitungscontainer und GDPR/CCPA-Konformität gewährleisten, dass hochgeladene Audiodaten niemals in ungeschütztem Zustand den Server verlassen.
- Interaktiver Playground-Demo: Benutzer können die Verbesserungs-Engine direkt im Browser testen, indem sie eine 30-Sekunden-Probe hochladen und sofort einen vorher-nachher-Vergleich hören.
- Umfassende Dokumentation & Support: Detaillierte API-Referenzen, Code-Snippets, Integrationsanleitungen und ein reaktives technisches Support-Team helfen Entwicklern, schnell in die Arbeit einzusteigen.
Installation & Nutzung: Schritt-für-Schritt-Anleitung
Herunterladen des Installers
Beginnen Sie, indem Sie die offizielle AI‑coustics-Website besuchen. Auf der Download-Seite erkennt die Seite automatisch Ihr Betriebssystem und zeigt die Schaltflächen „Download für Windows“, „Download für macOS“ oder „Download für Linux“ an. Jeder Installer ist mit einem vertrauenswürdigen Code-Signing-Zertifikat versehen, das eine malwarefreie Erfahrung garantiert. Windows-Nutzer erhalten einen .exe-Installer, macOS-Nutzer eine .dmg-Datei und Linux-Nutzer können zwischen .deb, .rpm oder einer komprimierten .tar.gz-Archiv wählen. Mobile Entwickler ziehen das SDK über ihren bevorzugten Paketmanager: npm install @ai‑coustics/hd‑speech für JavaScript, CocoaPods für iOS und Gradle für Android.
Installieren des Programms
Nach Abschluss des Downloads starten Sie den Installer. Unter Windows müssen Sie möglicherweise eine Benutzerkontensteuerung (UAC) genehmigen; unter macOS ziehen Sie das AI‑coustics-Symbol in den Ordner „Anwendungen“. Linux-Nutzer extrahieren das Archiv und führen install.sh aus, das automatisch Abhängigkeiten wie ffmpeg, libtorch und OpenCV auflöst. Der Installer fragt, ob der Befehlszeilen-Tool ai‑coustics in Ihren System-Pfad aufgenommen werden soll – wir empfehlen, diese Option zu aktivieren, um schnellen Zugriff über die Terminal-Eingabe zu haben.
Erste Konfiguration
Starten Sie die Desktop-Anwendung oder öffnen Sie ein Terminal und führen Sie ai‑coustics --setup aus. Ein Assistent führt Sie durch drei wesentliche Entscheidungen: (1) Auswahl eines Standard-Verarbeitungsmodus – „Echtzeit“ für Live-Verbesserung oder „Batch“ für Datei-basierte Verarbeitung; (2) Auswahl eines Sprachmodells – Englisch, mehrsprachig oder ein eigenes Modell, das Sie trainiert haben; und (3) Konfiguration der Datenschutzeinstellungen, einschließlich der Speicherung von API-Schlüsseln in verschlüsseltem lokalem Speicher. Wenn Sie die Cloud-API nutzen möchten, leitet der Assistent Sie zur Web-Oberfläche weiter, wo Sie einen sicheren API-Schlüssel generieren können.
Verbessern von Audiodateien
Für die Batch-Verarbeitung ziehen Sie einfach eine WAV-, MP3-, AAC-, FLAC- oder OGG-Datei per Drag & Drop in die Benutzeroberfläche und drücken auf „Verbessern“. AI‑coustics analysiert das Wellenform-Signal, wendet Resonanzunterdrückung, Kopfhörerkompensation und Artefakt-Reparatur an und speichert eine verlustfreie WAV-Datei im Ausgabeverzeichnis. Auf einem mittelständigen CPU (z.
B. Intel i5‑12400) beträgt die Verarbeitungszeit im Durchschnitt 1,2-fache der Originaldauer; durch Aktivierung der GPU-Beschleunigung (CUDA oder Metal) kann diese auf unter 0,5-fache reduziert werden. Die Echtzeit-Verbesserung funktioniert, indem Sie eine Mikrofon-Eingabe auswählen und „Live-Verbesserung“ aktivieren.
Der verarbeitete Audiostream kann direkt an beliebte Konferenz-Tools wie Zoom, Microsoft Teams oder OBS weitergeleitet werden und liefert Studioqualität ohne zusätzliche Hardware.
Integration des SDKs in Ihre Anwendungen
Entwickler integrieren AI‑coustics, indem sie das entsprechende SDK-Modul importieren. In Node.js installieren Sie das Paket mit npm install @ai‑coustics/hd‑speech und initialisieren den Client mit const client = new AICoustics({ apiKey: “YOUR_KEY” }). In Swift fügen Sie pod 'AICousticsSDK' zu Ihrer Podfile hinzu, importieren AICoustics und rufen client.enhance(buffer: audioBuffer) { result in … } auf. Das SDK unterstützt asynchrone Streaming und ermöglicht es Ihnen, Audio in 10-ms-Abschnitten zu liefern und niedriglatente Rückrufe für Fortschritt und Abschluss zu erhalten. Umfassende Beispielprojekte zeigen, wie die Engine in einen Podcast-Editor, einen Echtzeit-Gaming-Voice-Chat-Client oder eine serverseitige Transkriptions-Pipeline integriert wird.
Kompatibilität, Vor- und Nachteile sowie reales Leistungsverhalten
AI‑coustics läuft auf einer breiten Palette von Plattformen und gewährleistet, dass Sie Sprache überall verbessern können:
- Windows 10/11 (64-Bit)
- macOS 12 Monterey und neuer (Intel & Apple Silicon)
- Linux-Distributionen mit Kernel 5.4+ (Ubuntu, Fedora, Debian, Arch)
- Web-Browser mit WebAssembly-Unterstützung (Chrome, Edge, Firefox, Safari)
- Android 9+ (API 28) und iOS 13+ (iPhone & iPad)
Vorteile
- Die generative KI-Rekonstruktion liefert einen natürlichen, Studio-ähnlichen Klang, der einfache Rauschfilter deutlich übertrifft.
- Alles-in-einem-Lösung: Rauschunterdrückung, Resonanzentfernung, Kopfhörerkorrektur und Artefakt-Reparatur in einem Paket.
- Plattformübergreifendes SDK ermöglicht nahtlose Integration über Desktop, Mobilgeräte und Cloud-Umgebungen.
- Niedrige Latenz im Echtzeit-Modus, geeignet für Live-Streaming, Gaming und Videokonferenzen.
- Sichere Cloud-Verarbeitung mit Ende-zu-Ende-TLS-Verschlüsselung und GDPR/CCPA-Konformität.
- Umfangreiche Dokumentation, Beispielcode und reaktives technisches Support-Team reduzieren die Lernkurve.
- Der kostenlose Test im Playground-Demo ermöglicht die Bewertung der Technologie ohne Verpflichtung.
- GPU-Beschleunigung (CUDA, Metal, Vulkan) für unternehmensrelevante Durchsatzleistung verfügbar.
- Modulare Lizenzierung ermöglicht es kleinen Kreativen, den kostenlosen Tarif zu nutzen, während größere Teams für erweiterte Funktionen upgraden können.
- Regelmäßige Updates verbessern die Modellgenauigkeit und fügen neue Sprachunterstützung hinzu.
Nachteile
- Fortgeschrittene Funktionen wie GPU-Beschleunigung und individuelles Modelltraining erfordern eine kostenpflichtige Lizenz.
- Die Ersteinrichtung und Modellauswahl können für nicht-technische Nutzer einschüchternd sein.
- Modell-Dateien sind groß (~500 MB), was die Download-Zeit bei langsamen Verbindungen erhöht.
- Die Echtzeit-Verarbeitung auf veralteter Hardware kann geringe Latenz (≈150 ms) verursachen.
- Die Sprachunterstützung ist auf Haupt-Sprachen beschränkt; Nischen-Sprachen erfordern die Entwicklung eigener Modelle.
- Einige Nutzer berichten von höherem CPU-Verbrauch bei der Batch-Verarbeitung auf günstigen Laptops.
- Die Cloud-API-Preisgestaltung basiert auf Nutzung, was für Unternehmen mit hohem Volumen teuer werden kann.
- Obwohl die Benutzeroberfläche intuitiv ist, fehlen dem Befehlszeilen-Interface ausführliche visuelle Debugging-Tools.
- Die Integration mit bestimmten proprietären DAWs erfordert möglicherweise zusätzliche Wrapper-Skripte.
- Häufige Modell-Updates erfordern möglicherweise periodische Neuladungen, um aktuell zu bleiben.
Häufig gestellte Fragen
Wie unterscheidet sich AI‑coustics von herkömmlichen Rauschunterdrückungs-Software?
Herkömmliche Rauschunterdrückungs-Tools verwenden statische Frequenzmasken, um Hintergrundgeräusche zu unterdrücken, was oft die Stimmenhelligkeit beeinträchtigt. AI‑coustics setzt eine generative Sprach-KI-Engine ein, die nicht nur unerwünschtes Rauschen entfernt, sondern auch fehlende Hochfrequenzanteile rekonstruiert, Raumresonanzen eliminiert und die Frequenzantwort von Mikrofonen korrigiert, wodurch eine reichere, natürlichere Stimme entsteht.
Kann ich AI‑coustics auf einem Low-Budget-Laptop ausführen?
Ja. Der CPU-Modus läuft effizient auf den meisten modernen Laptops, obwohl die Verarbeitung langsamer ist als auf GPU-fähigen Geräten. Die Echtzeit-Verbesserung ist auf einem Dual-Core-Prozessor möglich, wobei die Latenz unter 150 ms bleibt – akzeptabel für die meisten Videokonferenz-Szenarien.
Sind meine Audiodaten sicher, wenn ich die Cloud-API verwende?
Alle Daten, die an die Cloud-API übertragen werden, sind mit TLS 1.3 verschlüsselt. Die Verarbeitung erfolgt in isolierten Containern, und kein Roh-Audio wird nach Abschluss der Aufgabe aufbewahrt. Der Dienst ist GDPR- und CCPA-konform, wodurch Ihre Aufnahmen privat und sicher bleiben.
Brauche ich eine Internetverbindung für die Desktop-Anwendung?
Nein. Die Desktop-Version enthält eine vollständig offline laufende Inferenz-Engine, die lokal auf Ihrem Gerät arbeitet. Die Cloud-API ist optional und nur erforderlich, wenn Sie die Verarbeitung auf entfernte GPUs auslagern oder serverseitige Skalierbarkeit benötigen.
Welche Audiodateiformate werden für die Batch-Verarbeitung unterstützt?
AI‑coustics akzeptiert WAV-, MP3-, AAC-, FLAC- und OGG-Dateien als Eingabe. Standardmäßig wird die verbesserte Ausgabe als verlustfreie WAV-Datei gespeichert, aber Sie können im Export-Setup auch MP3 oder AAC wählen, wenn kleinere Dateigrößen erforderlich sind.
Endgültige Bewertung und Handlungsaufforderung
AI‑coustics bietet eine leistungsstarke, KI-gesteuerte Audioverbesserungserfahrung, die dedizierte Hardwarelösungen erreicht. Seine generative Engine, der Echtzeit-Modus mit geringer Latenz und das umfassende plattformübergreifende SDK machen es zu einer attraktiven Wahl für Podcaster, Remote-Arbeitnehmer und Entwickler, die sprachzentrierte Anwendungen erstellen. Obwohl der Premium-Tarif für GPU-Beschleunigung und unternehmensrelevante Unterstützung erforderlich ist, bietet der kostenlose Tarif bereits spürbare Verbesserungen gegenüber herkömmlichen Rauschunterdrückern. Insgesamt erhält AI‑coustics eine solide Bewertung von 4,6 von 5 für Innovation, einfache Integration und konsistente Leistung auf Windows, macOS, Linux, Web, Android und iOS.
Bereit, Ihre Sprachaufnahmen professionell zu verbessern? Laden Sie AI‑coustics heute herunter, erkunden Sie die kostenlose Playground-Demo und erleben Sie selbst kristallklare Sprache. Wenn Sie bereit sind für erweiterte GPU-Beschleunigung oder unternehmensrelevante Unterstützung, aktualisieren Sie auf einen kostenpflichtigen Plan und treten der wachsenden Community von Kreativen bei, die AI‑coustics für jedes Sprecher-Engagement vertrauen.